
Los adjetivos son una clase de palabras que se definen por describir o modificar a los sustantivos a los que acompañan. Entre las lenguas del mundo, hay variación en la colocación de los adjetivos atributivos dentro del sintagma nominal (SN). Por ejemplo, en inglés los adjetivos se colocan casi exclusivamente antes del sustantivo que modifican (la anteposición), mientras que en español los adjetivos tienden a posponerse con respecto al sustantivo, fenómeno denominado posposición (Hoff, 2014; Kanwit & Terán, 2020). A pesar de esta tendencia general en español, la anteposición es posible y la variación entre la anteposición y la posposición del adjetivo se debe a un conjunto de factores relacionados con la semántica, el procesamiento, la frecuencia y el modo de comunicación (p. ej., Bosque & Demonte, 1999; Centeno-Pulido, 2012; Delbecque, 1990; File-Muriel, 2006; Hoff, 2014; Jacob, 2005; Kanwit & Berríos, 2019; Kanwit & Terán, 2020; Prado, 1980). En lo que respecta al presente estudio, los adjetivos suelen anteponerse cuando son más frecuentes en relación con el sustantivo, cuando tienen menos sílabas que este o cuando son sintácticamente simples, es decir, sin coordinación ni intensificación. Por otro lado, suelen posponerse cuando son más largos, más complejos, o menos frecuentes. Además, los factores de procesamiento tienden a ser más relevantes en el habla espontánea o informal, en comparación con el discurso preparado o la literatura.
Estos estudios anteriores indican que la variación en la colocación de los adjetivos en español es probabilística y basada en el uso. Sin embargo, solo existen dos estudios previos que consideran un aspecto de la frecuencia (la frecuencia relativa del adjetivo con respecto al sustantivo) en su análisis de la colocación del adjetivo (Kanwit & Berríos, 2019; Kanwit & Terán, 2020). Según un enfoque basado en el uso, se esperaría que la colocación del adjetivo estuviera influida también por la frecuencia de anteposición del bigrama particular [adjetivo específico + sustantivo específico] y del adjetivo con cualquier sustantivo, junto con la frecuencia léxica del adjetivo. Aunque estos factores relacionados con el uso no han sido considerados en estudios anteriores sobre el español, un estudio reciente sobre la colocación del adjetivo en francés, una lengua con muchas semejanzas con el español en esta variable morfosintáctica, indica que el comportamiento del bigrama específico y del adjetivo en general explican más variación en la posición del adjetivo que otros factores (Fox & Thuilier, 2012). Por consiguiente, en este trabajo se analiza el efecto de los patrones colocacionales de los adjetivos, en conjunto con los factores previamente estudiados, para comprender mejor cómo y por qué los adjetivos varían en su posición en español. En la próxima sección, se presenta el marco teórico del estudio.
Marco teórico
A pesar de algunas diferencias entre ellas, las perspectivas y teorías que se agrupan bajo el término de enfoques basados en el uso conceptualizan la lengua como la organización cognitiva de la experiencia acumulativa del individuo con el lenguaje (p. ej., Bybee, 2006; Goldberg, 2005; Langacker, 2000; Pierrehumbert, 2001, entre otros). Según estas teorías, cada instancia del uso lingüístico es procesada y almacenada en la representación mental del hablante, junto con información sobre su contexto de uso, tanto situacional como lingüístico. Este último incluye las formas con las que concurre cada ítem lingüístico, es decir, las combinaciones recurrentes de palabras en las que aparece (véase Díaz-Campos y Balasch [2023] para un volumen editado exhaustivo sobre este marco teórico).
Esta información se organiza en redes de representaciones que codifican relaciones de identidad, semejanza y diferencia entre formas. A partir de estas redes, emergen regularidades de uso, formando la estructura de la lengua. Desde esta perspectiva, la gramática es un sistema dinámico de tendencias probabilísticas que representan cómo se emplean las formas lingüísticas, con qué otras formas suelen coocurrir y en qué contextos sociales, físicos, culturales y discursivos se encuentran. Así, la lengua se compone de representaciones que abarcan tanto elementos individuales como secuencias más amplias, incluyendo combinaciones frecuentes de palabras.
Estas expresiones almacenadas no solo reflejan los usos previos, sino que también influyen en su procesamiento y producción futura. Así, la frecuencia con la que una forma o expresión aparece refuerza su representación mental y facilita su recuperación en situaciones posteriores. Esto implica que las formas lingüísticas más frecuentes tienden a procesarse y producirse con mayor rapidez y menor esfuerzo cognitivo. Además de estas expresiones específicas, los modelos basados en el uso reconocen la capacidad del sistema cognitivo-lingüístico para generalizar a partir de múltiples ejemplares similares. Los hablantes abstraen patrones productivos que forman la estructura de la lengua y guían el procesamiento y la producción. Estas abstracciones coexisten con las representaciones específicas. Así, el conocimiento lingüístico refleja una interacción continua entre conocimiento específico, derivado de ejemplares concretos, y conocimiento productivo, basado en patrones más amplios.
En lo que respecta al presente estudio, estos marcos teóricos predicen que la frecuencia de las formas no solo afecta la representación de elementos aislados, como un adjetivo específico, sino también la de combinaciones frecuentes, como una secuencia formada por un adjetivo específico y un sustantivo específico. Por ejemplo, aunque el adjetivo “actual” muestra una tendencia general hacia la posposición, con un índice de anteposición de 38,7% en el corpus utilizado, ciertas combinaciones frecuentes presentan comportamientos distintos. En el caso del bigrama “actual gobierno”, la tasa de anteposición asciende al 74,3%. Las expresiones que ocurren repetidamente en la experiencia acumulativa del individuo forman unidades cognitivas más arraigadas o fijadas, y se accede a ellas y se procesan como una unidad. Desde esta perspectiva, la frecuencia léxica de un adjetivo, su tendencia general a anteponerse y su comportamiento en combinaciones específicas constituyen factores fundamentales en la explicación de la variación morfosintáctica.
Finalmente, los enfoques basados en el uso reconocen que el procesamiento y la representación del lenguaje están mediados por las limitaciones generales de la cognición humana. Por ello, factores como la carga cognitiva, la complejidad sintáctica, o la longitud de los constituyentes también pueden influir en la producción lingüística o incluso ser la fuente de ciertos patrones observados (p. ej., Zahler, 2018). Por estas razones, este estudio adopta una perspectiva probabilística de la variación en la colocación del adjetivo, integrando tanto factores basados en el procesamiento como en el uso acumulativo del lenguaje. En la siguiente sección, se presenta un resumen del trabajo previo sobre la colocación del adjetivo en español.
La colocación de los adjetivos
En esta sección, se describen las distintas explicaciones de la colocación del adjetivo que se han propuesto en estudios anteriores. Primero, se presentan las explicaciones semánticas, seguidas de los enfoques basados en el procesamiento. Después, se resumen los estudios que consideran la frecuencia y, finalmente, los trabajos que muestran diferencias según el modo de comunicación. Al final de la sección, se destacan las lagunas de investigación que persisten en el estudio de la colocación variable del adjetivo en español y se justifica el presente estudio.
El efecto de la semántica
Muchos de los trabajos tempranos sobre la colocación del adjetivo en español se enfocaron en los factores sintáctico-semánticos. Las descripciones tradicionales de esta variable intentan explicar las diferencias de significado entre la anteposición y la posposición. Según estos trabajos (p. ej., Bosque & Demonte, 1999; Demonte, 1999, 2008; Jacob, 2005; Rothman et al., 2018), la posposición es preferida y más común, mientras que la anteposición está asociada con funciones semánticas especiales o conlleva significados distintos de los de la posposición.
En general, los estudios tradicionales han propuesto varias explicaciones. Primero, se ha observado que la anteposición puede cambiar el significado de algunos adjetivos; por ejemplo, “un viejo amigo” frente a “un amigo viejo” (p. ej., Demonte, 1999; Rothman et al., 2018). El primero significa un amigo de hace mucho tiempo, mientras que el segundo se refiere a un amigo de edad avanzada. El cambio específico depende del adjetivo en cuestión (véase Demonte [1999] para más ejemplos).
Además, se ha propuesto que la anteposición del adjetivo se emplea para referirse a la totalidad del grupo. Por ejemplo, en la frase “los enormes elefantes”, “enormes” sugiere que todos los elefantes del grupo comparten esa característica. En cambio, con el adjetivo pospuesto, “los elefantes enormes”, se alude a un subgrupo dentro del conjunto total de elefantes. Se ha observado que la anteposición suele tener una interpretación no restrictiva, es decir, se refiere al conjunto completo designado por el sustantivo, mientras que la posposición tiende a ser restrictiva, limitando la referencia a un subconjunto (p. ej., Demonte, 1999; Jacob, 2005). Otro punto destacado en la literatura previa es que la anteposición indica un mayor grado de subjetividad en comparación con la posposición. En general, la anteposición del adjetivo suele expresar una valoración subjetiva por parte del hablante, resaltando su actitud o emoción hacia el sustantivo. En cambio, la posposición tiende a aportar una descripción más objetiva o literal de la cualidad indicada (p. ej., Demonte, 2008). Es decir, la posición del adjetivo puede influir en el significado interpretado.
No obstante, aunque las descripciones tradicionales ofrecen una base sólida, no siempre existe una diferencia clara de significado según la posición del adjetivo. El contexto puede neutralizar las diferencias o hacer que ambas formas sean igualmente aceptables, como el ejemplo tomado de Hoff (2014, p. 2): “grandes problemas” frente a “problemas grandes”. En este caso, no se percibe una diferencia notable de significado. Por eso, varios investigadores han concluido que la variación en la colocación del adjetivo no siempre puede explicarse únicamente en términos de significado.
La influencia del procesamiento
Dado que la colocación adjetival no siempre conlleva diferencias semánticas, algunos estudios han explorado cómo el procesamiento influye en la colocación de los adjetivos en español. En las lenguas en general, se ha observado una tendencia hacia la posposición de elementos con mayor peso gramatical. Esta posposición se manifiesta como la colocación del elemento al final de la cláusula o después de otro constituyente con el cual mantiene una relación sintáctica (p. ej., Arnold et al., 2000; Hawkins, 1994; Hernández & Alcázar, 2014; Hoff, 2014; Kanwit & Berríos, 2019; Kanwit & Terán, 2020; McKinnon & Jung, 2024; Wasow, 1997). Por ejemplo, Wasow (1997) y Arnold et al. (2000) demostraron que el orden del objeto directo y del objeto indirecto después del verbo en las oraciones en inglés depende del peso gramatical de cada constituyente. En estos casos, se suele posponer el constituyente más pesado. En los estudios de la colocación del sujeto en español antes o después del verbo, también se ha observado un efecto del peso gramatical (p. ej., Hernández & Alcázar, 2014; McKinnon & Jung, 2024). Los sujetos con mayor peso gramatical suelen colocarse después del verbo.
Varios estudios han demostrado que el peso gramatical influye en la colocación del adjetivo antes o después del sustantivo en español (Centeno-Pulido, 2012; File-Muriel, 2006; Hoff, 2014; Kanwit & Berríos, 2019; Kanwit & Terán, 2020). El peso gramatical depende de la estructura, pero puede definirse según la cantidad de material en la forma o expresión, según su complejidad sintáctica o por una combinación de ambos aspectos (Wasow, 1997). El método más común para medir el peso gramatical en función de la cantidad de material en los estudios de los adjetivos en español es el peso silábico, el cual se refiere a la comparación del número de sílabas entre el adjetivo y el sustantivo. Diversos estudios han encontrado que los adjetivos más cortos en relación con el sustantivo, es decir, los que tienen menos sílabas que el sustantivo que modifican, tienden a anteponerse, mientras que los más largos se posponen (Centeno-Pulido, 2012; File-Muriel, 2006; Hoff, 2014; Kanwit & Terán, 2020).
El método más común para medir el peso gramatical según la complejidad sintáctica es la complejidad del sintagma adjetival (SADJ). En español, los SADJs pueden ser más complejos por la presencia de un intensificador, como en “un mensaje realmente hermoso”, en el que el intensificador “realmente” modifica el adjetivo “hermoso”. Asimismo, el SADJ puede ser más complejo con la presencia de un adjetivo coordinado, como en “un suceso extraordinario y terrible”. En el caso del español, solo Hoff (2014) ha considerado la complejidad del SADJ en su análisis. Sus resultados muestran que en el habla espontánea hay más posposición cuando el SADJ tiene dos adjetivos coordinados o un intensificador.
El papel de la frecuencia
Dos estudios recientes han considerado el papel de la frecuencia de los adjetivos o los sustantivos en la colocación del adjetivo en español (Kanwit & Berríos, 2019; Kanwit & Terán, 2020), aunque otros investigadores han sugerido su importancia con anterioridad. Según File-Muriel (2006), se acceden y se procesan más rápidamente los adjetivos que ocurren con mayor frecuencia, y, por lo tanto, pueden aparecer antes del sustantivo que modifican debido a su mayor accesibilidad. Kanwit y Berríos (2019) y Kanwit y Terán (2020) también proponen que los adjetivos más frecuentes suelen extenderse a contextos sintácticos nuevos más fácilmente, convirtiéndose en unidades más autónomas, menos afectadas por las reglas sintácticas dominantes en la lengua. Por eso, en estos dos últimos estudios se investigó el efecto de la frecuencia relativa del adjetivo en su colocación. Los autores observaron que cuando el adjetivo era más frecuente que el sustantivo con el que aparecía, aumentaba la tasa de anteposición.
El impacto de la modalidad
Al combinar los resultados de los trabajos anteriores sobre la colocación del adjetivo en español, se observa que existe un conjunto de factores semánticos, de procesamiento y de frecuencia que impactan de manera combinada esta variable morfosintáctica. No obstante, entre los estudios previos también se observa que la influencia de estas variables varía según la modalidad. Primero, los factores relacionados con el procesamiento tienen un mayor impacto con el efecto esperado en el habla espontánea en comparación con el habla preparada o el discurso escrito (Centeno-Pulido, 2012; File-Muriel, 2006; Hoff, 2014). Aunque Hoff (2014) encontró más posposición del adjetivo en el habla espontánea cuando el SADJ llevaba otro adjetivo coordinado o intensificador, observó más anteposición con adjetivos coordinados en el habla preparada (p. ej., el discurso presidencial) y en la ficción escrita (p. ej., las novelas), lo que constituye el efecto opuesto. Asimismo, Hoff encontró que el peso silábico tenía el efecto esperado en el habla espontánea, pero no así en los discursos preparados ni en la ficción escrita. Esto sugiere que los factores relacionados con el procesamiento cognitivo tienen un mayor impacto en modalidades más informales y espontáneas, mientras que su efecto puede verse atenuado con la preparación. Estos resultados son respaldados con el estudio de Centeno-Pulido (2012), quien encontró mayor efecto del peso silábico en el habla semiformal que en los discursos presidenciales, y por los hallazgos de Prado (1980), quien no observó ningún efecto del peso silábico en cuatro novelas. Así, el análisis de la variación en la colocación adjetival debe considerar no solo las propiedades lingüísticas del adjetivo y el discurso adyacente, sino también el contexto comunicativo en el que aparece.
La contribución de este estudio
Estos trabajos sobre el habla espontánea, el habla preparada y formal, y la escritura literaria nos han aportado mucha información sobre el conjunto de factores que influyen en la colocación de los adjetivos en español. Sus observaciones permiten entender que las tendencias de la colocación adjetival no solo dependen de reglas gramaticales abstractas, sino también del uso repetido, de las demandas del procesamiento, del tipo de discurso y de la interacción entre estos factores. Sin embargo, persisten varias lagunas en nuestra comprensión de cómo y por qué el adjetivo se coloca antes o después del sustantivo. Primero, aunque se ha demostrado que la frecuencia relativa del adjetivo es un factor importante en la colocación adjetival, no se han considerado más factores relacionados al uso o la frecuencia. Sobre todo, podrían ser importantes la frecuencia de la anteposición en el bigrama particular (es decir, la frecuencia de anteposición en la combinación específica de un adjetivo y un sustantivo) y la frecuencia con la que el adjetivo se antepone con cualquier sustantivo.
Partiendo de las perspectivas basadas en el uso aplicadas a la variación morfosintáctica, se esperaría una fuerte influencia de estas dos variables en la colocación adjetival, ya que el uso acumulativo de estas formas en la experiencia del hablante influiría en su producción. Las construcciones más frecuentes están más arraigadas en la memoria y se accede a ellas y se producen con mayor facilidad y frecuencia que construcciones alternativas posibles pero menos frecuentes (Goldberg, 2019). Por ejemplo, las combinaciones más frecuentes de adjetivo con sustantivo en inglés, como “absolute silence”, “silencio absoluto”, se reconocen más fácilmente que otras combinaciones posibles como “pure silence”, “silencio puro”. Para la estructura objeto de este estudio, una investigación semejante analizó la colocación del adjetivo con respeto al sustantivo en francés, una lengua que comparte muchas características con el español en esta variable (Fox & Thuilier, 2012). En este estudio, se demostró la importancia de incluir las variables colocacionales, ya que predijeron la variación en la posición del adjetivo mejor que la frecuencia simple, el peso silábico, y la complejidad del SADJ.
Otra brecha investigativa es el estudio de la variación probabilística de la colocación adjetival en la escritura más informal y menos preparada, como los blogs en línea. Definir los blogs en términos técnicos resulta complejo; sin embargo, se clasifican en diferentes tipos, como narrativos, informativos y opinativos. Dentro de la categoría narrativa destacan los blogs de narración personal, que constituyen un subregistro particularmente frecuente (Biber et al., 2015). En el presente estudio, utilizamos la clasificación del corpus y solo analizamos un ejemplo si el texto estaba etiquetado como blog. Según nuestra observación, estos textos se componían mayoritariamente de narración personal. No se ha considerado el género de los blogs anteriormente en estudios previos sobre la colocación del adjetivo en ninguna lengua. Sin embargo, dadas las diferencias ya demostradas entre otras modalidades comunicativas en cuanto a esta variable morfosintáctica en estudios anteriores, cabe preguntarse cómo los factores semánticos, de procesamiento, y de uso podrían impactar la posición del adjetivo en blogs de escritura informal. Un estudio reciente sobre el sueco comparó los blogs con el habla semiformal y con la escritura formal y editada, y encontró que los blogs comparten rasgos tanto del habla como de la escritura, por lo que pueden considerarse un modo intermedio (Wiktorsson, 2018). Es posible que los efectos de los factores relacionados con el procesamiento y el uso sean más importantes en los blogs que en la escritura más preparada y formal.
Por ello, este estudio amplía nuestra comprensión de la colocación de los adjetivos de dos maneras. Primero, se considerarán las tendencias de los adjetivos y de los bigramas a anteponerse junto con los factores previamente considerados en estudios anteriores, adoptando una perspectiva basada en el uso para explicar esta variable morfosintáctica. Segundo, se extiende el análisis de esta estructura a un tipo de escritura informal, los blogs, una plataforma que combina rasgos tanto del habla como de la escritura planificada.
Con estos objetivos en mente, las preguntas de investigación de este estudio son las siguientes:
-
¿Cómo se colocan los adjetivos con respecto a los sustantivos en blogs escritos en línea en español mexicano?
-
¿Cuál es el efecto de la clase semántica en la colocación del adjetivo?
-
¿Cuál es la influencia de los factores relacionados al procesamiento en esta variable, es decir, la complejidad del SADJ, la complejidad del SN y el peso silábico relativo del adjetivo?
-
¿Cuál es el efecto de las variables relacionadas con el uso repetido, es decir, la frecuencia léxica del adjetivo y la tendencia del adjetivo y del bigrama particular a anteponerse?
-
¿Cómo interactúan estas variables semánticas, de procesamiento y de uso en su influencia en la colocación del adjetivo?
-
¿En qué medida se asemejan los blogs al habla oral?
Dados los estudios anteriores, se plantea la hipótesis de que los factores relacionados con el uso serán los más importantes en la colocación del adjetivo, seguidos por los factores de procesamiento y, finalmente, por los factores semánticos. Para los factores de procesamiento, se espera una mayor frecuencia de anteposición en los SADJs menos complejos, en los SNs más complejos y con un menor peso silábico. Con respecto a los factores relacionados con el uso, se predice que habrá un mayor efecto de las tendencias colocacionales que de la frecuencia del adjetivo. Además de ello, se espera una mayor influencia de los factores relacionados con el procesamiento en los bigramas infrecuentes o variables, mientras que los bigramas con altos niveles de anteposición o posposición serán menos afectados, ya que se procesarán y producirán como unidades. Por último, es difícil predecir la influencia de la clase semántica, dado que su efecto varía entre estudios anteriores.
Metodología
Datos
Este estudio se basa en datos del subcorpus Web/Dialects del Corpus del Español (Davies, 2016-), de los cuales se seleccionaron exclusivamente los textos de blogs escritos en México. Se recopilaron 1080 ejemplos en total, correspondientes a 60 casos para cada uno de los 18 adjetivos elegidos, alistados en la Tabla 1. Para los adjetivos que presentan variación de género y número, como “bonito”, se distribuyeron 15 casos por cada forma: “bonito”, “bonita”, “bonitos”, y “bonitas”. En el caso de los adjetivos que no marcan género, como “horrible”, se incluyeron 30 ejemplos en singular (“horrible”) y 30 en plural (“horribles”), manteniendo el equilibrio en la distribución morfológica. Para evitar la influencia de patrones individuales de los autores, se seleccionó únicamente un caso de cada blog individual.
No se incluyeron casos de colocaciones invariables, como “pantalones cortos”, ya que este bigrama tiene el adjetivo exclusivamente pospuesto, lo que no permite observar variación. El objetivo fue centrarse en adjetivos que muestran posibilidades reales de alternancia entre anteposición y posposición, dentro del SN. Los ejemplos se seleccionaron manualmente a través de búsquedas filtradas, y se utilizaron los primeros 60 casos de cada adjetivo que cumplieron con los criterios de selección.
Variable dependiente
La variable dependiente de este estudio es la colocación del adjetivo dentro del SN. Esta variable tiene dos categorías. Una categoría es la anteposición, cuando el adjetivo aparece antes del sustantivo, como en “las bajas vibraciones”. La otra categoría es la posposición, que ocurre cuando el adjetivo aparece después del sustantivo, por ejemplo, “una casa bonita”. La muestra se distribuyó de manera bastante equilibrada: del total de 1080 casos, 522 ejemplos (48,3 %) corresponden a la colocación antepuesta, mientras que 558 casos (51,7 %) presentan la colocación pospuesta.
Variables independientes
La primera variable independiente es la clase semántica del sustantivo, con los casos categorizados como evaluativos, de tamaño/forma y temporales. La segunda variable independiente es el peso silábico. El peso silábico es la diferencia en el número de sílabas entre el adjetivo y el sustantivo, y se calcula restando el número de sílabas del sustantivo al del adjetivo. Por ejemplo, “enorme” tiene tres sílabas y “popularidad” tiene cinco sílabas; por lo tanto, el valor resultante -2, y cae en la categoría de ≤ -2. Las otras categorías son: -1, 0 y 1+. Por lo general, hubo muy pocos casos de adjetivos que tenían dos o más sílabas más que el sustantivo que modificaban (N = 11), posiblemente porque los adjetivos analizados en este estudio contienen entre una y tres sílabas, mientras que el número de sílabas en los sustantivos presenta un mayor rango de variación. Por eso, se agruparon todos los casos en los que el adjetivo es más largo que el sustantivo en la categoría de 1+. Aunque esta agrupación no permite una comparación directa entre las categorías de ≤-2 y 2+, la proporción de casos de 2+ no fue suficiente para mantener esta categoría como independiente en el análisis. Otra variable independiente que se considera es la complejidad del SADJ. La complejidad del SADJ se define según si el adjetivo aparece solo, con intensificador, o coordinado con otro adjetivo. Por ejemplo, en el caso de “ritmo constante y agradable”, “constante” y “agradable” son un SADJ con dos adjetivos coordinados. La tercera variable independiente es la complejidad del SN. Esta variable se divide en tres categorías: (i) sustantivo solo, con o sin determinante; (ii) sustantivo con cuantificador; y (iii) sustantivo compuesto. Por ejemplo, “en varias historias cortas”, “varias” funciona como cuantificador dentro del SN.
También se consideraron varias medidas relacionadas con el uso. Primero, se incluyó la frecuencia léxica de la forma específica del adjetivo. Este valor se obtuvo a partir de los datos mexicanos del Corpus del Español Web/Dialects (Davies, 2016-). Así, se calculó un número individual para cada una de las variantes de género y número, como “bonito”, “bonita”, “bonitos” y “bonitas”. Este valor se escaló en R para facilitar el análisis estadístico.
Además, se determinó la frecuencia de anteposición del bigrama particular (p. ej., “bajas” + “vibraciones”). Primero, se contó el número de ocurrencias del bigrama particular (antepuesto y pospuesto) en todos los datos mexicanos en el Corpus del Español Web/Dialectos y se calculó la proporción de estos usos que son antepuestos. Segundo, se computó el porcentaje de uso de un bigrama particular (por ejemplo, “enorme” modifica el sustantivo “esfuerzo” en 164 casos) con respecto al total de usos del adjetivo en esa misma forma específica (p. ej., “enorme” en singular, sin el número de casos en plural) dentro de un SN (N = 14098). Para “enorme” con “esfuerzo”, este cálculo resultó en un porcentaje de 1,16%. Es decir, todos los casos con “enorme” antepuesto o pospuesto a “esfuerzo” representaron el 1,16% de todos los usos de “enorme” con un sustantivo en los datos mexicanos del corpus. Posteriormente, se utilizaron la proporción de anteposición del bigrama y la frecuencia del bigrama particular para crear cuatro categorías de la variable “frecuencia de anteposición del bigrama”. Para todos los bigramas específicos que representaban 0,5% o menos de todos los usos del adjetivo con cualquier sustantivo, se clasificaron como infrecuentes. Para los bigramas que constituían más de 0.5% de los datos, se clasificaron como variables, pospuestos o antepuestos, en función de la tasa de anteposición del bigrama. Los bigramas variables se anteponen en más de 30% de sus usos pero en menos del 70%. Los bigramas antepuestos se anteponen en un 70% o más de los casos, mientras que los pospuestos se anteponen en un 30% o menos. Por ejemplo, “esfuerzo” ocurrió con “enorme” en 164 casos y 118 de estos (o 71,95%) presentaron el adjetivo antepuesto, por lo que este bigrama se clasificó como antepuesto. En la Tabla 3 se presentan ejemplos de este cálculo (entre paréntesis tras cada ejemplo). Cabe destacar que estos límites se establecieron a priori, lo cual constituye una limitación metodológica que se discutirá en la sección de discusión.
La última variable independiente relacionada con el uso fue el porcentaje de anteposición del adjetivo (en su forma específica) con cualquier sustantivo en el corpus mexicano. Para su cálculo, se contabilizaron todos los casos en los que el adjetivo específico aparece antepuesto al sustantivo que modifica (p. ej., “actual” + sustantivo, N = 10873), y este valor se dividió entre el total de usos del adjetivo específico, tanto antepuesto como pospuesto (p. ej., “actual” antes o después del sustantivo, N = 28187). Para “actual”, este cálculo resultó en un 38,6%. Esta variable independiente se modeló como continua.
Análisis
Para analizar el efecto de las variables independientes sobre la colocación del adjetivo, se llevó a cabo una regresión logística binomial mixta en R con la función glmer del paquete lme4 (Bates et al., 2015). La variable dependiente fue la posición del adjetivo. Las variables independientes fueron la complejidad del SN, la complejidad del SADJ, el peso silábico, la clase semántica, la frecuencia léxica (escalada) del adjetivo, la frecuencia de anteposición del bigrama y el porcentaje de anteposición del adjetivo. Se incluyó el adjetivo como efecto aleatorio. Para esta última variable, se dividieron los adjetivos en singular y plural, pero se agruparon las variantes de género cuando correspondía. Esta decisión se tomó para mantener un número equilibrado de ocurrencias y la comparabilidad entre adjetivos de dos y cuatro formas, partiendo de la idea de que la combinación del adjetivo con el sustantivo particular, más que la marca de género del adjetivo, condiciona su posición. Si se hubieran separado las formas de género, los efectos de género se habrían captado en los adjetivos de cuatro formas (p. ej., “lindo/linda”), pero no en los de dos (“frecuente/frecuentes”), lo que habría generado una estructura de efectos aleatorios metodológicamente inconsistente.
Para examinar la interacción entre las variables independientes y su efecto combinado en la colocación del adjetivo, se utilizó un árbol de inferencia condicional con la función ctree en el paquete partykit en R (Hothorn & Zeileis, 2015). Este análisis permite identificar si determinadas combinaciones de valores de las variables predictoras están asociadas con diferencias significativas en la colocación del adjetivo. A través de divisiones sucesivas basadas en pruebas estadísticas, el árbol segmenta los datos en subgrupos homogéneos y revela umbrales críticos en variables continuas, así como interacciones entre variables categóricas y continuas. Esto facilita la identificación de patrones no lineales y efectos contextuales que pueden pasar desapercibidos en un modelo lineal tradicional.
Resultados
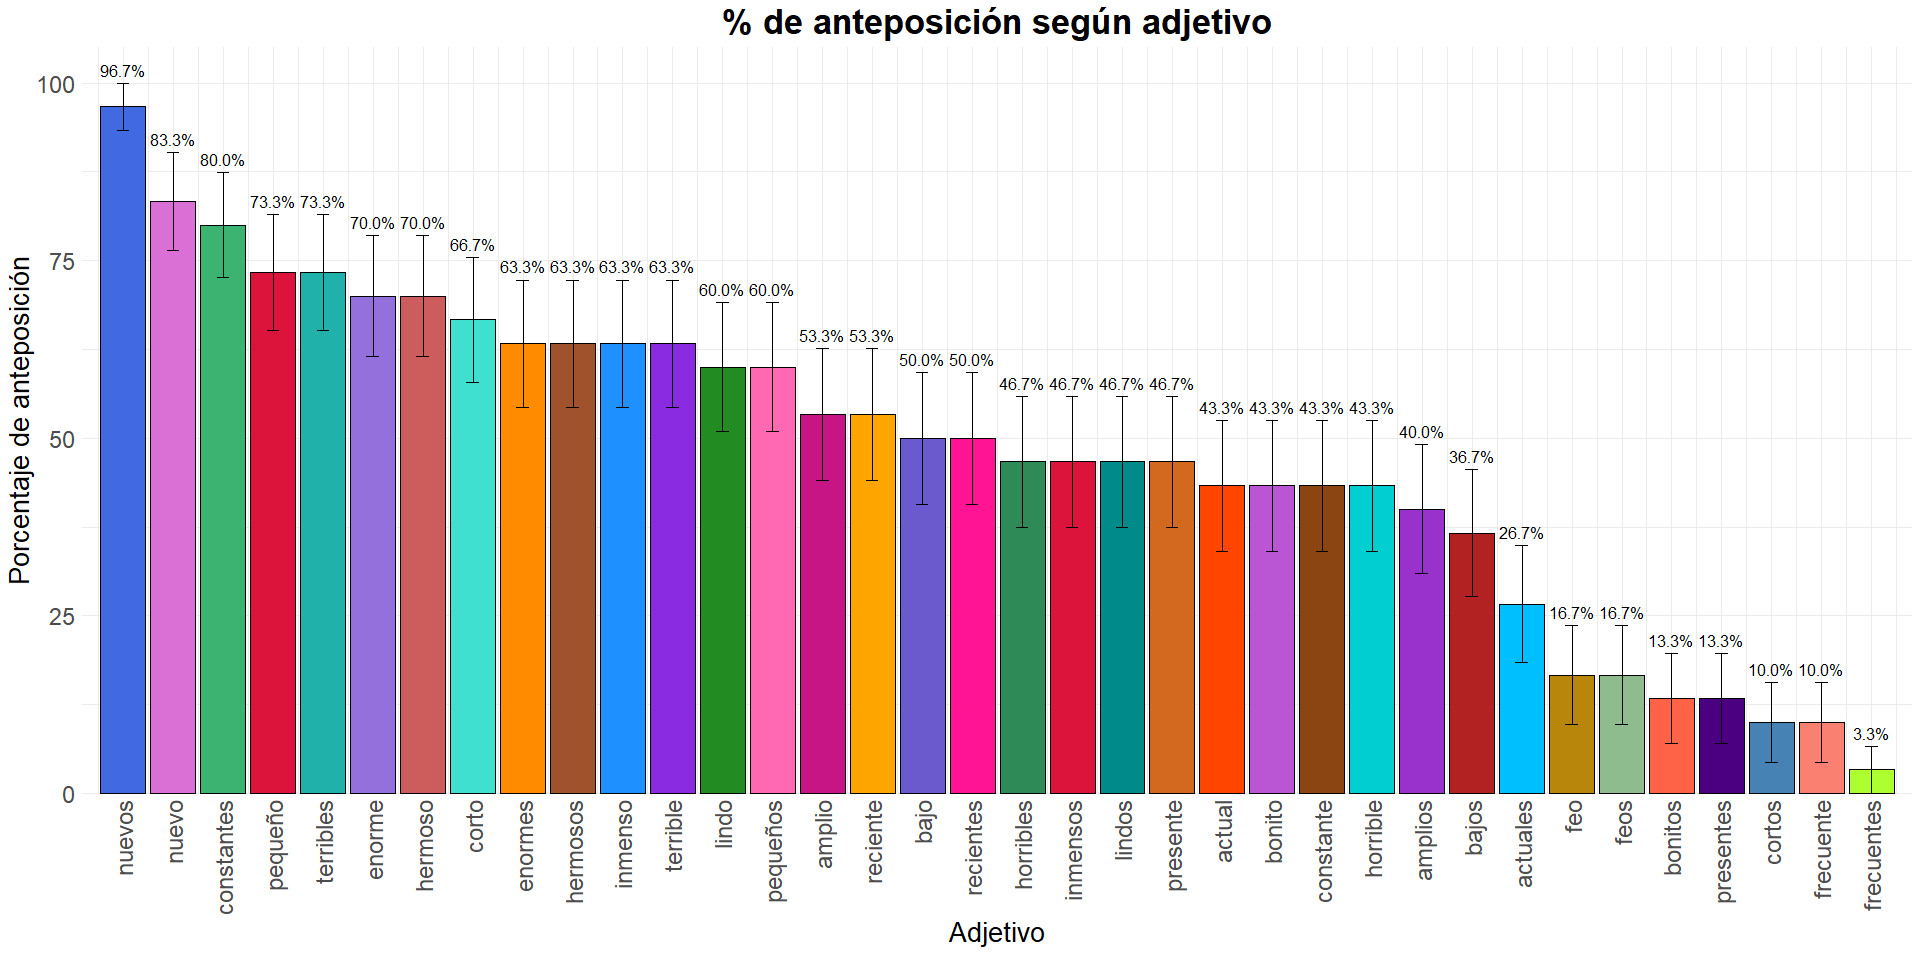
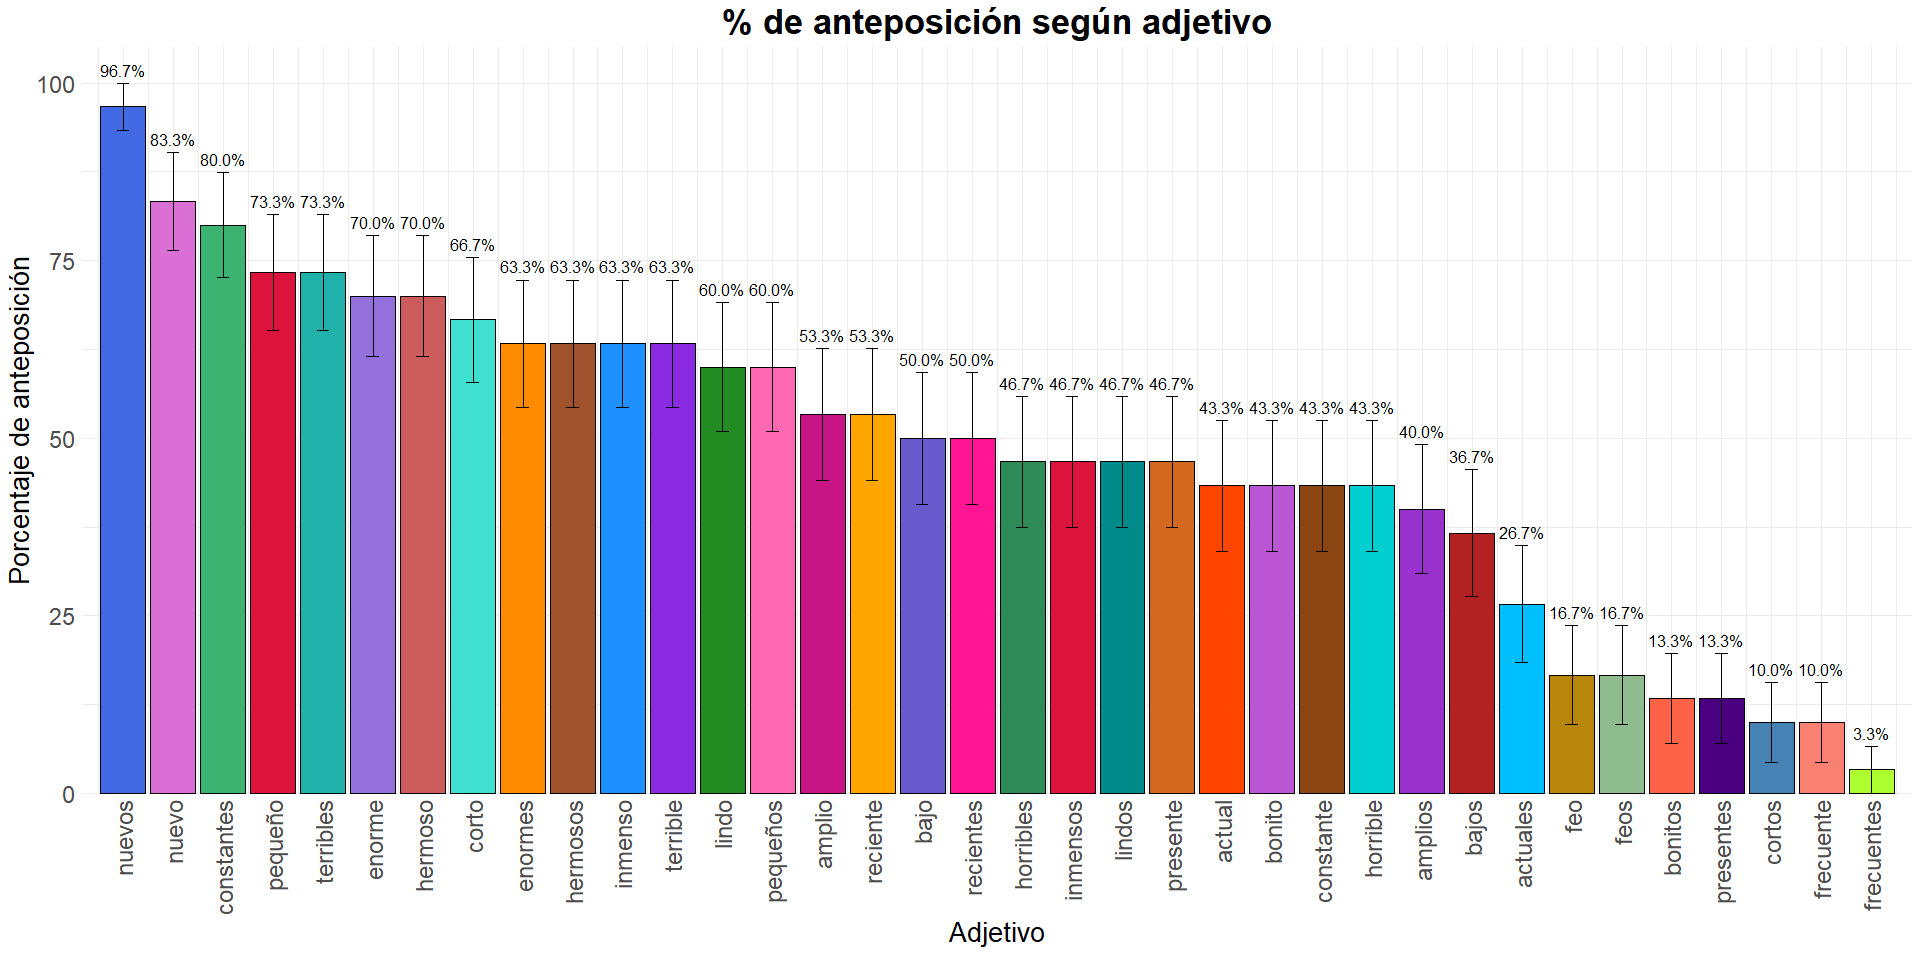
En esta sección, se presentan los resultados del estudio. Como ya se ha demostrado, la distribución de la anteposición (48,3%) y la posposición (51,7%) fue relativamente equitativa en la muestra en su conjunto. Sin embargo, se observó una considerable variación según el lema del adjetivo individual, incluso entre las formas singulares y plurales. Aunque todos los adjetivos demostraron variación, la tasa de anteposición varió entre 3,3% y 96,7%. Se ilustra la distribución de anteposición según adjetivo específico en la Figura 1.
En la Tabla 4, se presentan los resultados de la regresión logística binomial mixta. En el análisis, se estableció una de las categorías de la variable dependiente y de las variables independientes categóricas como base de comparación. Para la variable dependiente, la base de comparación es la posposición; por lo tanto, el análisis indica qué factores predicen el uso de la anteposición. Para la complejidad del SADJ, la base de comparación fue el adjetivo solo y para la complejidad del SN, la base de comparación fue el sustantivo solo. Para el peso silábico, la categoría de referencia fue 1+ (cuando el adjetivo es más largo que el sustantivo) y para la frecuencia de anteposición del bigrama, la base fue el bigrama antepuesto. No hubo base de comparación para la frecuencia léxica del adjetivo ni para el porcentaje de anteposición del adjetivo, ya que estos factores fueron continuos.
El análisis proporciona estimaciones y valores de p del efecto de las categorías de las variables independientes. Para las variables independientes categóricas, un valor de p menor de .05 indica que la categoría correspondiente tiene un efecto significativo; es decir, la tasa de anteposición es significativamente diferente con respecto a la categoría de referencia. Por ejemplo, la categoría de ≤ -2 para el peso silábico tiene un valor de p < .05, lo que indica que la tasa de anteposición es significativamente diferente de la base de comparación, la categoría 1+. Para cada categoría, una estimación positiva indica que dicha categoría favorece la anteposición en comparación con la base. Siguiendo este ejemplo, la estimación es 0,636 para la categoría de ≤ -2 del peso silábico, lo que indica que cuando el adjetivo tiene dos o más sílabas menos que el sustantivo, hay una mayor probabilidad de anteposición que cuando el adjetivo es más largo que el sustantivo.
Como se muestra en la Tabla 4, la complejidad del SADJ, el peso silábico, la frecuencia de anteposición del bigrama, y el porcentaje de anteposición del adjetivo tuvieron efectos significativos, mientras que la complejidad del SN, la clase semántica, y la frecuencia léxica del adjetivo no resultaron significativos. Se observa una mayor probabilidad de anteposición cuando el SADJ incluye un intensificador en comparación con un adjetivo solo. Asimismo, hay significativamente más anteposición cuando el sustantivo tiene dos sílabas o más que el adjetivo en comparación con los casos en que el adjetivo es más largo que el sustantivo. En cuanto a la frecuencia de anteposición del bigrama, en nuestros datos los bigramas infrecuentes, variables y pospuestos en el corpus más amplio muestran significativamente menos anteposición que los bigramas que se anteponen con mayor frecuencia. Finalmente, hay una mayor probabilidad de anteposición en nuestros datos cuando el adjetivo presenta tasas más altas de anteposición en general.
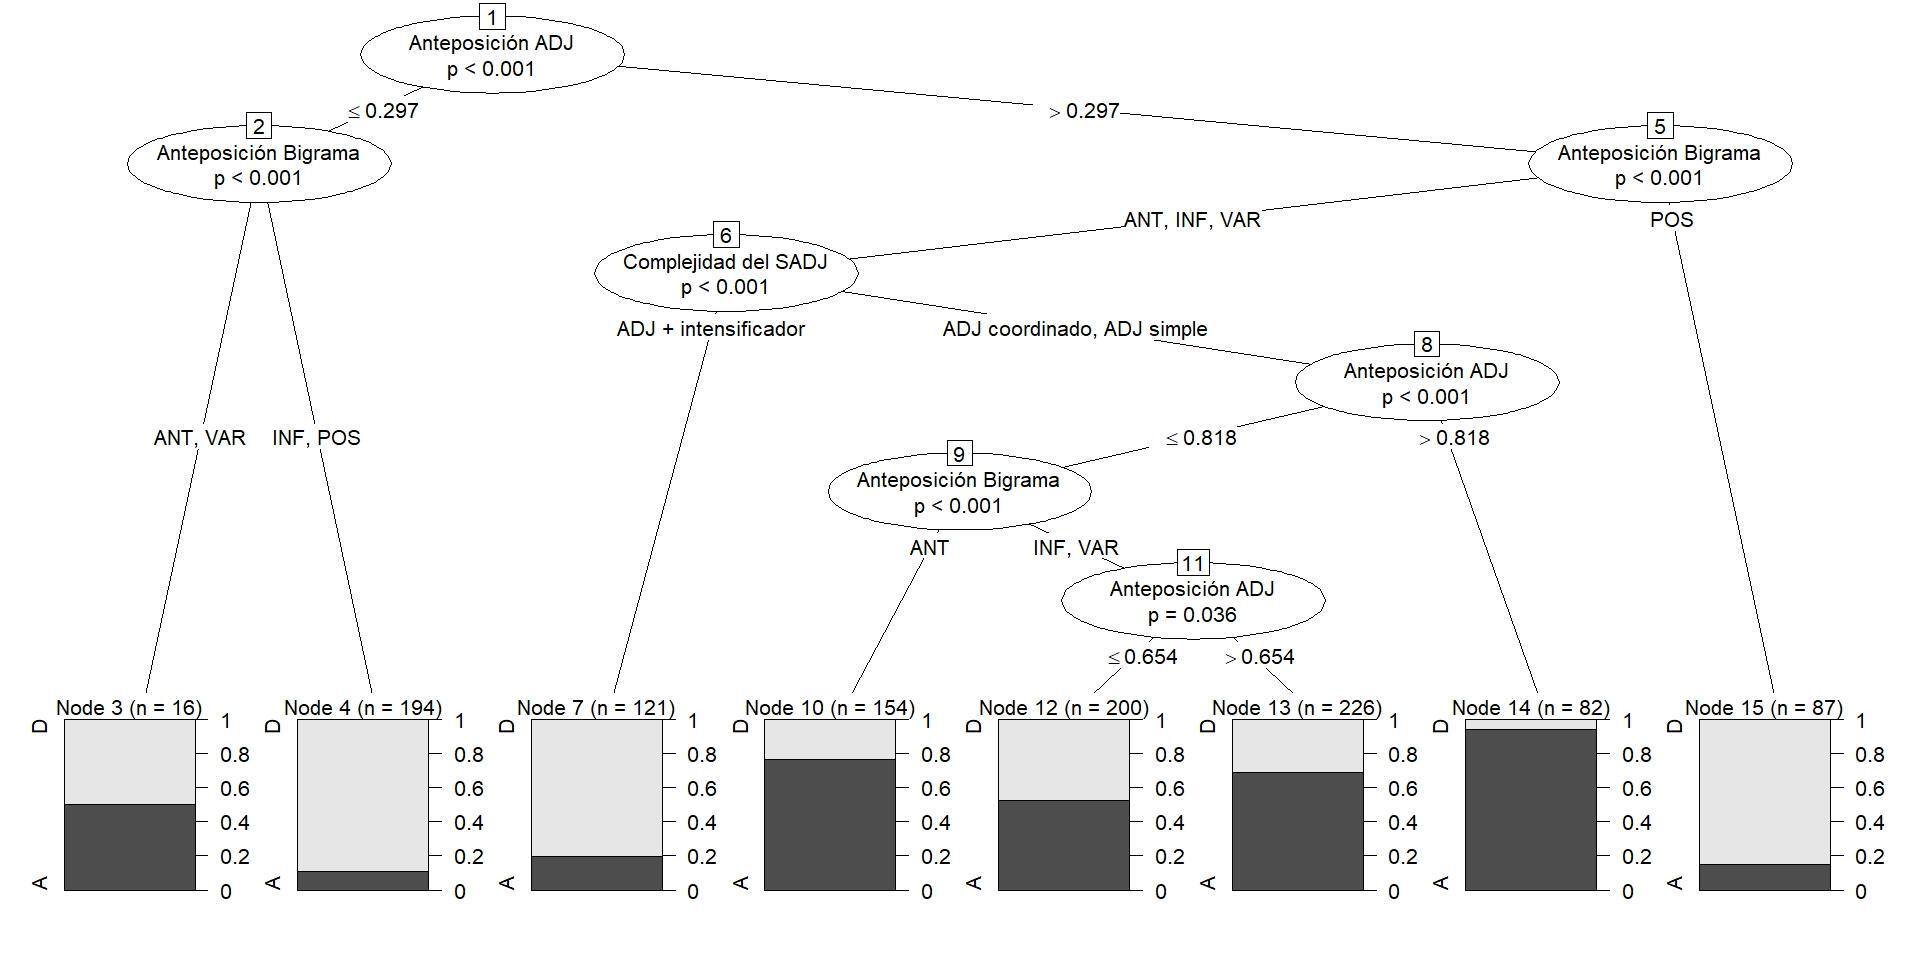
Se ilustran los resultados del análisis del árbol de inferencia condicional en la Figura 2. En esta figura, se observa una relación compleja entre los efectos de las siguientes variables: el porcentaje de anteposición del adjetivo, la frecuencia de anteposición del bigrama y la complejidad del SADJ. El análisis reveló que la variable más influyente fue el porcentaje de anteposición del adjetivo, que divide el árbol en el nodo raíz con un umbral de 0,297. Entre los adjetivos que tienen una frecuencia de anteposición del adjetivo menor del 29,7%, la frecuencia de anteposición del bigrama distingue entre aquellos con mayor probabilidad de anteposición, las categorías de bigramas antepuestos y variables, y los bigramas infrecuentes y pospuestos, que tienden mayoritariamente a aparecer en posición posnominal.
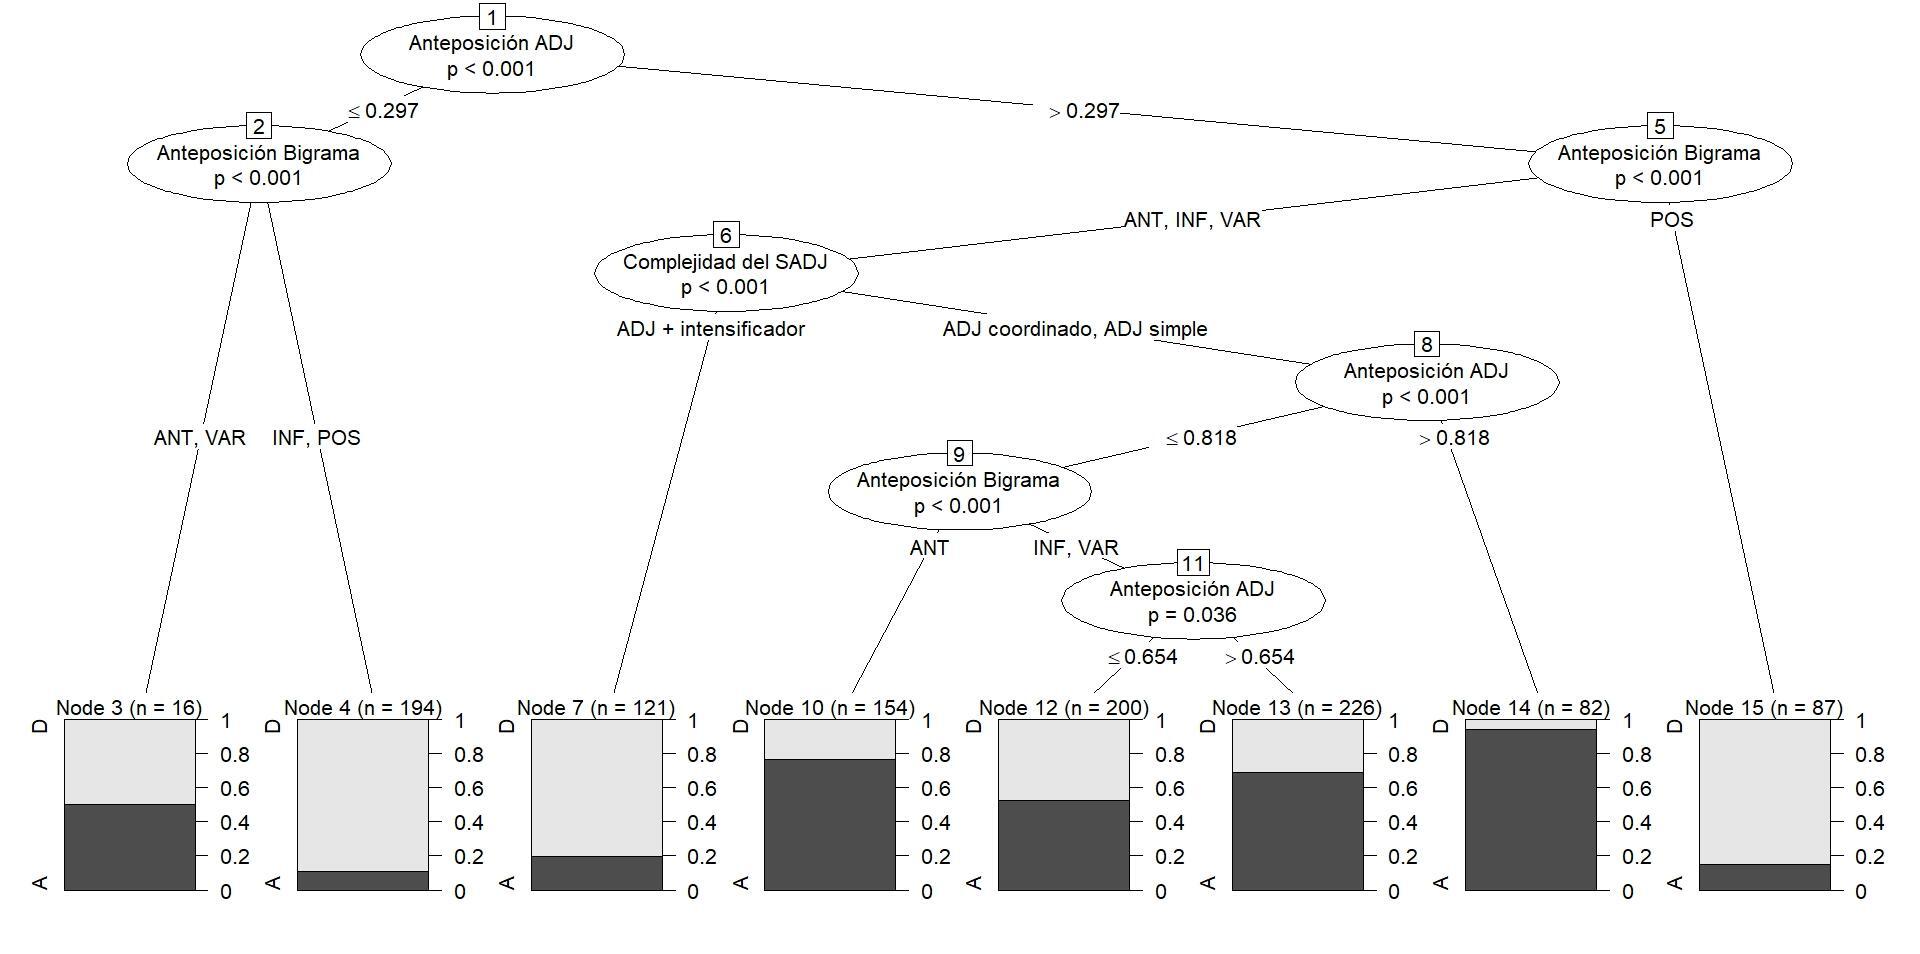
En el otro lado del árbol, cuando el adjetivo tiene una frecuencia de anteposición mayor del 29,7%, la interacción entre la frecuencia del bigrama y la complejidad del SADJ produce subdivisiones adicionales. En particular, los bigramas que suelen ser pospuestos, se mantienen pospuestos, a diferencia del comportamiento general del adjetivo. Sin embargo, para los bigramas que suelen ser antepuestos, infrecuentes y variables, hay una interacción compleja de variables que afectan la colocación adjetival. Como se ve en la rama izquierda del nodo 6, cuando hay un intensificador dentro del SADJ, los adjetivos demuestran una fuerte tendencia a posponerse. En la rama derecha del nodo 6, se observa que los bigramas antepuestos, infrecuentes y variables, con adjetivos coordinados o adjetivos simples, suelen seguir los patrones del adjetivo en general. Para aquellos que tienen una alta tasa de anteposición del adjetivo (81,8% o más), se observa casi exclusivamente la anteposición (ver nodo 14). Para aquellos que tienen una tasa de anteposición del adjetivo menor del 81,8%, hay una interacción entre las tendencias del bigrama y del adjetivo a anteponerse.
En total, el árbol muestra que hay una interacción compleja entre las tendencias del adjetivo en general y del bigrama particular, y que el procesamiento sólo influye en la colocación en un contexto específico: se posponen los bigramas antepuestos, infrecuentes y variables de adjetivos variables o mayormente antepuestos cuando el SADJ contiene un intensificador. Aparte de este efecto, son las variables de uso y frecuencia las que principalmente rigen la variación.
Discusión
En esta sección se aborda una discusión de los resultados de este estudio. Primero, se responden las preguntas de investigación y se evalúan las hipótesis. En la segunda sección se conectan los resultados de este estudio con estudios anteriores y con los enfoques basados en el uso.
Preguntas de investigación e hipótesis
Nuestras preguntas de investigación se concentraron en la distribución de la anteposición y posposición del adjetivo en los blogs mexicanos, en cómo su colocación se ve afectada por los factores relacionados con la semántica, el procesamiento y el uso, así como en la interacción entre estos factores. Además, se planteó la cuestión de la semejanza entre los blogs y el habla oral, al menos en lo que respecta a la estructura bajo estudio. Para estas preguntas, se hipotetizó que los adjetivos serían variables en cuanto a su posición relativa al sustantivo, y que su colocación estaría más influida por factores relacionados con el uso que por los factores de procesamiento y semánticos. Específicamente, se esperaba una mayor anteposición con SADJs menos complejos, con SNs más complejos y con menor peso silábico, y que las tendencias colocacionales de los adjetivos con sustantivos específicos y en general serían más importantes en comparación con la frecuencia léxica del adjetivo. Finalmente, se predijo que los blogs se asemejarían al habla oral por su carácter más informal y menos planificado.
Nuestros resultados confirman en gran medida las hipótesis. Primero, se observó que existe una considerable variación en la colocación de los adjetivos en blogs mexicanos, ya que la anteposición y la posposición ocurrieron a tasas prácticamente iguales. En cuanto a la variable independiente relacionada con la semántica, la clase semántica del adjetivo no tuvo un efecto significativo para los adjetivos estudiados en este estudio. Respecto a los factores relacionados con el procesamiento, tanto el peso silábico como la complejidad del SADJ fueron significativos, generalmente en la dirección esperada. Se observó mayor anteposición con los adjetivos más cortos que sus sustantivos correspondientes (diferencia de dos sílabas o más), mientras que los adjetivos más largos que los sustantivos se posponían con mayor frecuencia. En cuanto a la complejidad del SADJ, su efecto se limitó a los contextos con intensificador, y no a los adjetivos coordinados.
Por otro lado, dos de los factores basados en el uso fueron particularmente importantes: se observó que las propiedades del bigrama en particular y del adjetivo en general fueron los factores más determinantes en la colocación adjetival, según el análisis con el árbol de inferencia condicional y las estimaciones obtenidas en el modelo de regresión. El porcentaje de anteposición del adjetivo y la frecuencia de anteposición del bigrama fueron las variables más importantes en el árbol, ya que ocuparon nodos más altos y produjeron más divisiones en comparación con los factores de procesamiento. Cabe destacar que el procesamiento solo tuvo un efecto cuando el SADJ contenía un intensificador. Según el árbol, este efecto del intensificador se dio únicamente con los bigramas variables, infrecuentes o con alta tendencia a la anteposición dentro de la categoría de adjetivos variables o de frecuente anteposición. Los adjetivos y bigramas que muestran una preferencia por la posposición no fueron impactados por la presencia de un intensificador, dado que ya aparecen mayoritariamente en posición posnominal. El peso silábico no apareció en el árbol de inferencia condicional, lo que indica que su impacto en la colocación del adjetivo no es tan determinante. No obstante, es importante destacar que los árboles de inferencia condicional no incluyen el efecto aleatorio de adjetivo, y es posible que algunas de las diferencias entre el árbol de inferencia y la regresión se deban a tendencias idiosincráticas de adjetivos individuales.
A continuación, aunque es difícil comparar directamente con el habla ya que se consideraron factores adicionales en el presente estudio en comparación con estudios previos, se observan algunos efectos de procesamiento en los blogs, mientras que la clase semántica no tiene un efecto significativo. Estos patrones en nuestros datos son más semejantes al habla informal o semiformal que al habla preparada o la ficción, dadas las tendencias encontradas en estas modalidades en estudios anteriores (p. ej., Centeno-Pulido, 2012; Hoff, 2014; Prado, 1980). Desde una perspectiva basada en el uso, estas semejanzas con el habla se entienden mejor si consideramos que el almacenamiento de formas lingüísticas por parte de los hablantes es multidimensional: la experiencia acumulada con distintos géneros también moldea las asociaciones colocacionales y de frecuencia que ocurren en cada modalidad distinta. Así, los hablantes no solo reconocen qué combinaciones son frecuentes, sino también en qué contextos de género resultan más esperables o apropiadas, lo que explica que la prosa de blogs se acerque más a registros informales que a modalidades más planificadas. Por último, es importante destacar que la única hipótesis no confirmada se relaciona con la complejidad del SN, ya que no hubo un efecto significativo de esta variable, lo que sugiere que la complejidad del SADJ es más importante, al menos en el contexto discursivo (blogs) y lingüístico (los adjetivos particulares) de nuestro estudio.
Conexión con la literatura previa
Los resultados del presente estudio no solo son esperados, sino que también refuerzan los postulados centrales de las teorías lingüísticas basadas en el uso. Estos enfoques plantean que la gramática emerge del uso reiterado de formas lingüísticas en contextos particulares y que las unidades léxicas y combinaciones frecuentes de ítems lingüísticos se almacenan como representaciones mentales, facilitando su procesamiento y producción. Nuestros hallazgos demuestran claramente que los factores relacionados con el uso y la frecuencia, sobre todo la frecuencia de patrones gramaticales en contextos específicos, fueron los predictores más importantes en la colocación adjetival, superando a los factores de procesamiento y semánticos. Estos resultados se alinean con los estudios que han examinado cómo las medidas de frecuencia específicas de la variable estudiada pueden explicar mejor la variación que la simple frecuencia (p. ej., Raymond & Brown, 2012; véase Brown [2023] para una síntesis de este tema). En particular, como señalan Brown y colegas, la frecuencia en entornos específicos constituye un factor condicionante más fuerte de la variación que la frecuencia general, lo cual sitúa nuestros hallazgos dentro de esta línea de trabajo más amplia. En nuestro estudio, los patrones de uso del adjetivo específico y del bigrama particular influyen de manera decisiva en la variación, mientras que la frecuencia léxica global del adjetivo en sí no ejerce un efecto significativo. En conjunto, estos hallazgos también resultan altamente compatibles con la Gramática de Construcciones, dado que esta perspectiva enfatiza la importancia de las combinaciones frecuentes como unidades cognitivas (Goldberg, 2005) y se relaciona con los análisis colostrucionales que exploran cómo las asociaciones entre palabras y construcciones reflejan preferencias probabilísticas de uso (Stefanowitsch & Gries, 2003).
Estos resultados concuerdan con lo observado por Fox y Thuilier (2012) en francés. En su estudio, encontraron que la frecuencia colocacional resultó ser más influyente que la frecuencia léxica simple o la complejidad estructural. En nuestro estudio, esta misma tendencia se manifiesta en español: los bigramas con patrones altamente establecidos de anteposición o posposición ejercen una fuerte influencia sobre la colocación del adjetivo, aun cuando los adjetivos en sí presentan una tendencia distinta y sin que la frecuencia léxica general del adjetivo ejerza un efecto significativo. Por otra parte, los bigramas infrecuentes siguieron los patrones más generales del adjetivo: si el adjetivo solía anteponerse, un bigrama infrecuente demostró el mismo patrón, mientras que los bigramas infrecuentes de adjetivos generalmente pospuestos solían posponerse. Así, tal como proponen los modelos basados en el uso, las secuencias frecuentes se procesan como unidades holísticas, reduciendo la carga cognitiva y reforzando la preferencia por una determinada ordenación. Por ejemplo, Bybee (2006) argumenta que la repetición conduce a la autonomía de las formas frecuentes, de modo que estas llegan a almacenarse y procesarse como unidades independientes, lo cual facilita su acceso y consolida su influencia en los patrones gramaticales. En línea con esta propuesta, nuestros resultados muestran que el conocimiento de ítems y colocaciones específicos, como los bigramas [adjetivo + sustantivo] considerados en este estudio, ejerce un impacto significativo en la variación. La fuerte influencia de bigramas particulares puede explicar por qué existen diferencias de colocación entre adjetivos relacionados, como se ilustró en la Figura 1. Por ejemplo, “constantes” presenta una alta tasa de anteposición (80%) mientras que “constante”, aunque difiere solo en número, se antepone 43,3% del tiempo. En este caso, en nuestros datos “constante” se utilizaba en conjunto con sustantivos como “control”, “forma”, “lucha”, “ritmo”, “deseo”, y “enojo”, entre otros, todos los cuales son más cortos o de igual longitud que el adjetivo, lo cual favorece la posposición. Por otra parte, “constantes” se combinaba con sustantivos como “actitudes”, “agresiones”, “inquietudes”, “exposiciones”, y “fluctuaciones”, entre otros. Estos sustantivos son más largos que el adjetivo, un contexto favorable a la anteposición. Si una porción importante de los sustantivos con los que un adjetivo suele combinarse son más cortos que el adjetivo y, por ello, el adjetivo suele posponerse, es posible que el adjetivo en general se tienda más hacia la posposición en combinaciones infrecuentes. Esta propuesta se alinea con los resultados de nuestro estudio y un marco teórico basado en el uso, y un estudio con más casos por adjetivo y un rango más amplio de sustantivos podría confirmar estas tendencias.
Al mismo tiempo, son importantes los patrones más abstractos o productivos, como las tendencias de los adjetivos en general con cualquier sustantivo, lo que pone de relieve la importancia del conocimiento productivo. Finalmente, aunque no se encontró un efecto significativo de la frecuencia léxica del adjetivo en ninguno de los dos análisis, ni la regresión ni el árbol de inferencia, puede que este resultado se deba a los adjetivos específicos que se incluyeron en el análisis. Estos adjetivos fueron generalmente frecuentes y no se examinaron los adjetivos ni altamente frecuentes ni infrecuentes. Sin embargo, algunos adjetivos en español son particularmente frecuentes y con formas cortas o reducidas (p. ej., “buen”, “gran”, “mal”, etc.) y se anteponen casi categóricamente. En este sentido, existe una interacción compleja entre la frecuencia, el peso silábico y la anteposición en los adjetivos más frecuentes. Además, es posible que los adjetivos menos frecuentes sean más largos y tiendan a posponerse o verse más afectados por los factores de procesamiento. Es importante considerar un rango más amplio de adjetivos en estudios futuros del mismo tema para ver si hay un efecto de frecuencia léxica con una muestra más variada y para determinar si hay interacciones entre la frecuencia léxica y las tendencias colocacionales o los factores de procesamiento. Aunque nuestros resultados coinciden con los hallazgos de Fox y Thuilier (2012) sobre el francés, quienes sí incluyeron una mayor diversidad de adjetivos en su análisis, es posible que nuestros resultados cambien con la inclusión de más adjetivos. Otra limitación potencial se relaciona con la categorización del factor “tendencia del bigrama particular.” Si bien la intención inicial era tratar esta variable como continua, la baja frecuencia de algunos bigramas obligó a transformarla en una variable categórica, lo que impuso límites previos al análisis. En investigaciones futuras, convendría excluir las colocaciones poco frecuentes y centrarse en los bigramas con suficiente frecuencia para medir esta variable, de modo que la “tendencia del bigrama particular” pueda analizarse como variable continua.
Asimismo, nuestros resultados demuestran la importancia del procesamiento en la producción de la morfosintaxis variable, pero indican que esta importancia es mayor en construcciones composicionales que en vez de construcciones o colocaciones accedidas y producidas como una unidad.
Finalmente, es importante considerar el posible papel de dos factores adicionales. El primero es la configuración sintáctica, particularmente la posición del SN con respecto al verbo. Trabajos anteriores han demostrado que el orden de palabras en español (p. ej., la posición del sujeto con respecto al verbo) está estrechamente relacionado con la estructura informativa y la focalización (Leonetti, 2014; Zubizarreta, 1998). En particular, los sujetos posverbales suelen asociarse con la introducción de información nueva o focalizada, lo que podría favorecer ciertos patrones de colocación adjetival. En este sentido, es plausible que la colocación del adjetivo interactúe con factores discursivo-pragmáticos a nivel oracional. Sin embargo, hasta donde sabemos, el efecto de la configuración sintáctica de la oración no ha sido estudiado sistemáticamente como variable independiente en los estudios de la colocación adjetival desde una perspectiva variacionista o basada en datos de corpus, ni se incluyó en el presente análisis, dado nuestro enfoque en factores internos al SN. Esto constituye una limitación del presente estudio y futuras investigaciones deberían integrar variables sintácticas y de estructura informativa para evaluar de manera más directa su impacto en la colocación del adjetivo.
En cuanto al segundo factor, la variable de clase semántica, su efecto limitado en nuestros resultados puede explicarse, al menos en parte, por la naturaleza no discreta de las categorías semánticas empleadas. En particular, los adjetivos clasificados dentro de la categoría de tamaño (p. ej., “pequeño”, “amplio”, etc.) son adjetivos gradables cuya interpretación depende en gran medida de la percepción del hablante. En numerosos casos de nuestros datos, estos adjetivos admiten tanto una interpretación dimensional (relacionada con el tamaño físico o la extensión) como una lectura evaluativa (relacionada con la importancia, gravedad o relevancia), como en “una pequeña imperfección” o “un amplio sector de la población”. Esta superposición semántica dificulta una clasificación categórica estricta y sugiere que las categorías semánticas operan de manera más bien gradual y dependiente del contexto discursivo. En consecuencia, la posible ambigüedad en la interpretación de estos adjetivos puede haber atenuado los efectos asociados a la clase semántica en nuestros modelos. Estos resultados se ajustan bien a una teoría basada en el uso, ya que el significado emerge de la interacción entre propiedades léxicas, contexto y experiencia lingüística, en lugar de ajustarse a categorías semánticas rígidas. En conjunto, los hallazgos de este estudio se alinean con el postulado de las teorías basadas en el uso, según el cual se afirma que “cuando la experiencia con ítems específicos es limitada, el procesamiento se puede apoyar con el conocimiento productivo” (Morgan & Levy, 2024: p. e198; nuestra traducción).
Conclusión
El presente estudio nos permite llegar a varias conclusiones sobre la colocación adjetival en los blogs en línea, un modo intermedio entre el habla y la escritura formal. En primer lugar, la tendencia del adjetivo y del bigrama hacia la anteposición son los factores más influyentes. Encontramos que los bigramas, combinaciones de adjetivo específico con sustantivo particular, que mostraron predisposición fuerte hacia la anteposición o posposición no presentaron efectos de las otras variables independientes. Sin embargo, en ausencia de una fuerte predisposición, los bigramas más variables o infrecuentes fueron más impactados por la tendencia general del adjetivo hacia la anteposición o posposición y los factores de procesamiento.
Estos resultados demuestran que los bigramas frecuentes con un orden de palabra más fijo se almacenan en la representación cognitiva de la lengua como una unidad y se acceden y producen como una unidad. Al mismo tiempo, los bigramas menos frecuentes y sin orden de palabras tan rígido mostraron mayor sensibilidad a los patrones productivos del adjetivo y del procesamiento. Por consiguiente, este efecto combinado de los factores relacionados con el uso y el procesamiento respalda los marcos teóricos basados en el uso, los cuales postulan que el conocimiento específico y productivo de la lengua influye en su procesamiento y producción. En el caso de la posición del adjetivo en español, los patrones de ítems específicos, los bigramas particulares, y el conocimiento productivo, las tendencias del adjetivo en general, rigen la colocación del adjetivo en una interacción compleja, con influencia de los factores de procesamiento especialmente en los adjetivos y bigramas con patrones menos rígidos.
Este estudio también revela la importancia de considerar el efecto de la modalidad y de extender la metodología de la presente investigación al análisis del habla oral informal y de textos escritos formales como punto de comparación. Dado el hecho de que los factores colocacionales parecen más importantes que los factores de procesamiento en los blogs, resulta necesario reexaminar otras modalidades ya estudiadas para ver si los factores colocacionales se atenúan en textos escritos más planificados o en el habla oral espontánea. Al realizar esta comparación, se debe incluir la gama total de factores posibles que pueden influir en la posición del adjetivo, incluidos los factores colocacionales, la frecuencia del adjetivo, los factores de procesamiento, y la clase semántica, para evaluar si es posible explicar una mayor proporción de la variación en otros contextos discursivos.
Anteposición ADJ = tasa de anteposición del adjetivo; Anteposición bigrama = tasa de anteposición del bigrama [ANT = antepuesto; INF = infrecuente; POS = pospuesto; VAR = variable]